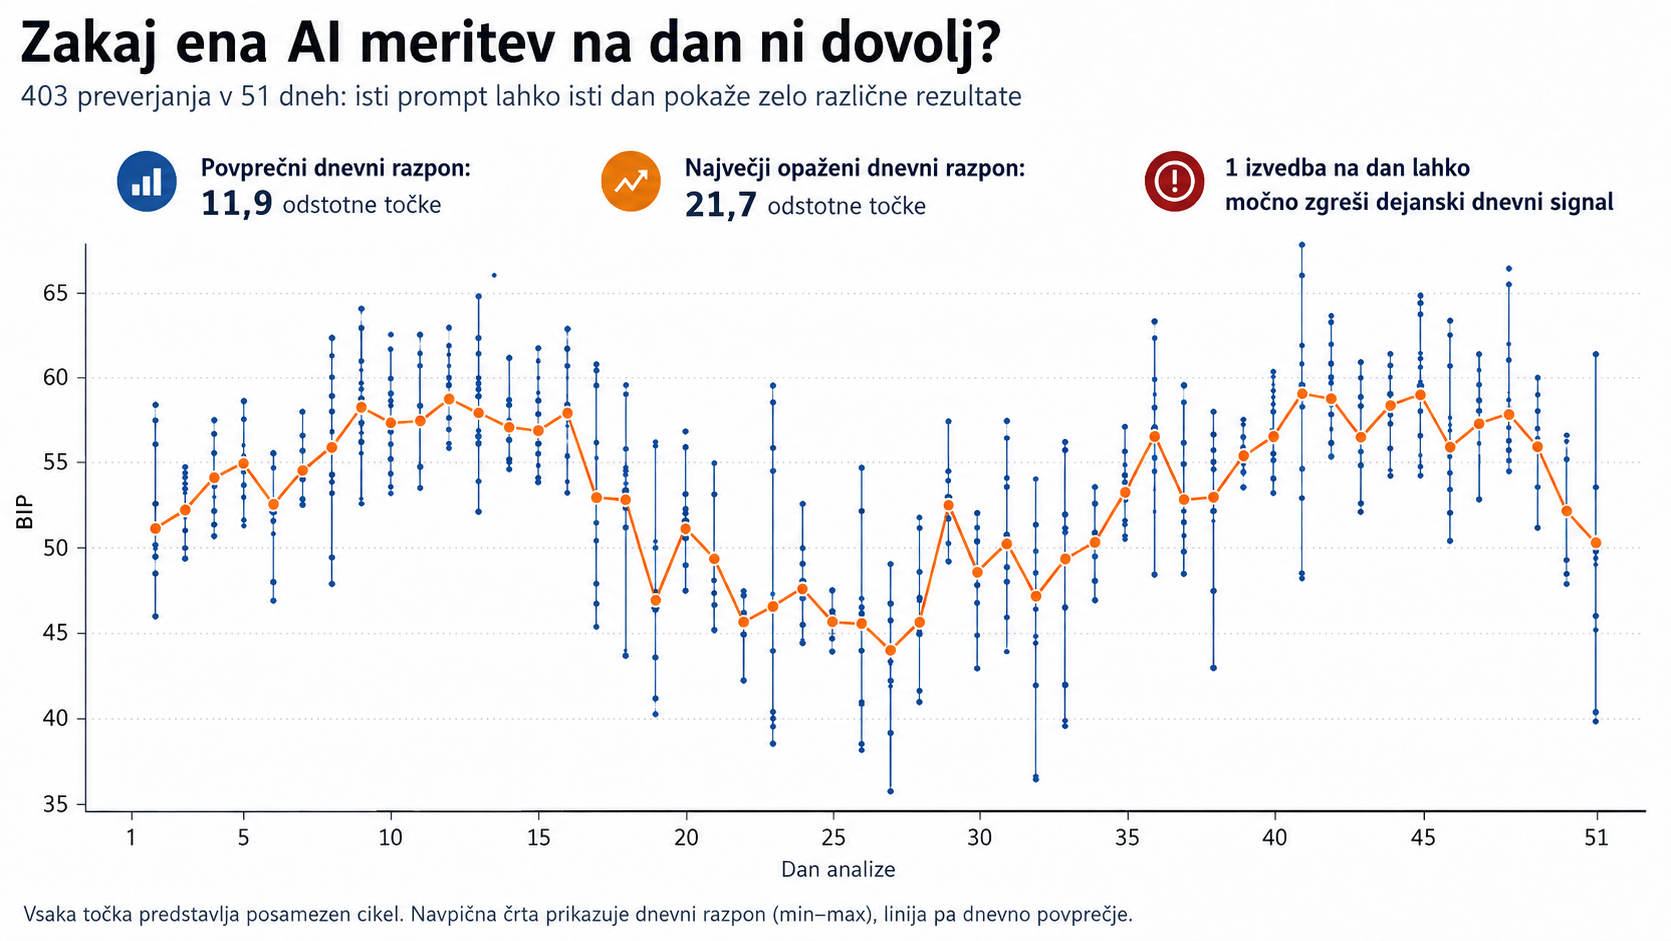
Analiza 403 BIP ciklov v 51 dneh pokaže, zakaj je enkratna dnevna meritev predvsem posnetek trenutka – ne pa zanesljiv dnevni KPI.
Veliko orodij za spremljanje vidnosti blagovnih znamk v ChatGPT, Gemini in drugih AI okoljih uporablja preprost pristop: vsak prompt izvede enkrat na dan, rezultat pa predstavi kot dnevno stanje AI vidnosti.
Tak pristop je poceni in na prvi pogled logičen. Statistično pa je problematičen.
Veliki jezikovni modeli ne delujejo kot klasičen iskalnik ali podatkovna baza, ki bi ob isti poizvedbi vedno vrnila enak rezultat. Njihovi odgovori so verjetnostni. Isti prompt lahko v dveh zaporednih izvedbah izpostavi različne blagovne znamke, spremeni vrstni red priporočil ali znamko enkrat vključi, drugič pa izpusti.
Zato en odgovor ni meritev vidnosti. Je samo ena opazovana realizacija možnega odgovora.
Kaj smo analizirali?
Analizirali smo razširjen nabor podatkov iz realnega projekta spremljanja AI vidnosti. Podatke smo zbrali z Imhotep Lens, sistemom za spremljanje AI vidnosti, ki omogoča ponavljajoče meritve istega nabora promptov skozi čas. Skupaj je analiza zajemala 51 merjenih dni in 403 posamezne BIP cikle. V 47 dneh je bilo izvedenih vseh osem načrtovanih ciklov, zato smo te popolne dneve uporabili tudi za primerjavo, kako natančnost dnevne ocene narašča z več ponovitvami.
Končni vzorec je obsegal:
- 51 merjenih dni,
- 403 posamezne cikle,
- 47 popolnih dni z 8 cikli.
Ključna metrika je bila BIP oziroma Brand Inclusion Probability. BIP meri verjetnost, da bo spremljana blagovna znamka vključena v odgovor AI modela pri izbranem naboru promptov, trgih in modelih.
Za analizo stabilnosti smo na 47 popolnih dnevih kot referenčno dnevno vrednost uporabili povprečje vseh osmih ciklov. Nato smo preverili, kako bi se ocena spremenila, če bi dnevni rezultat temeljil na eni, dveh, treh, štirih ali več ponovitvah.
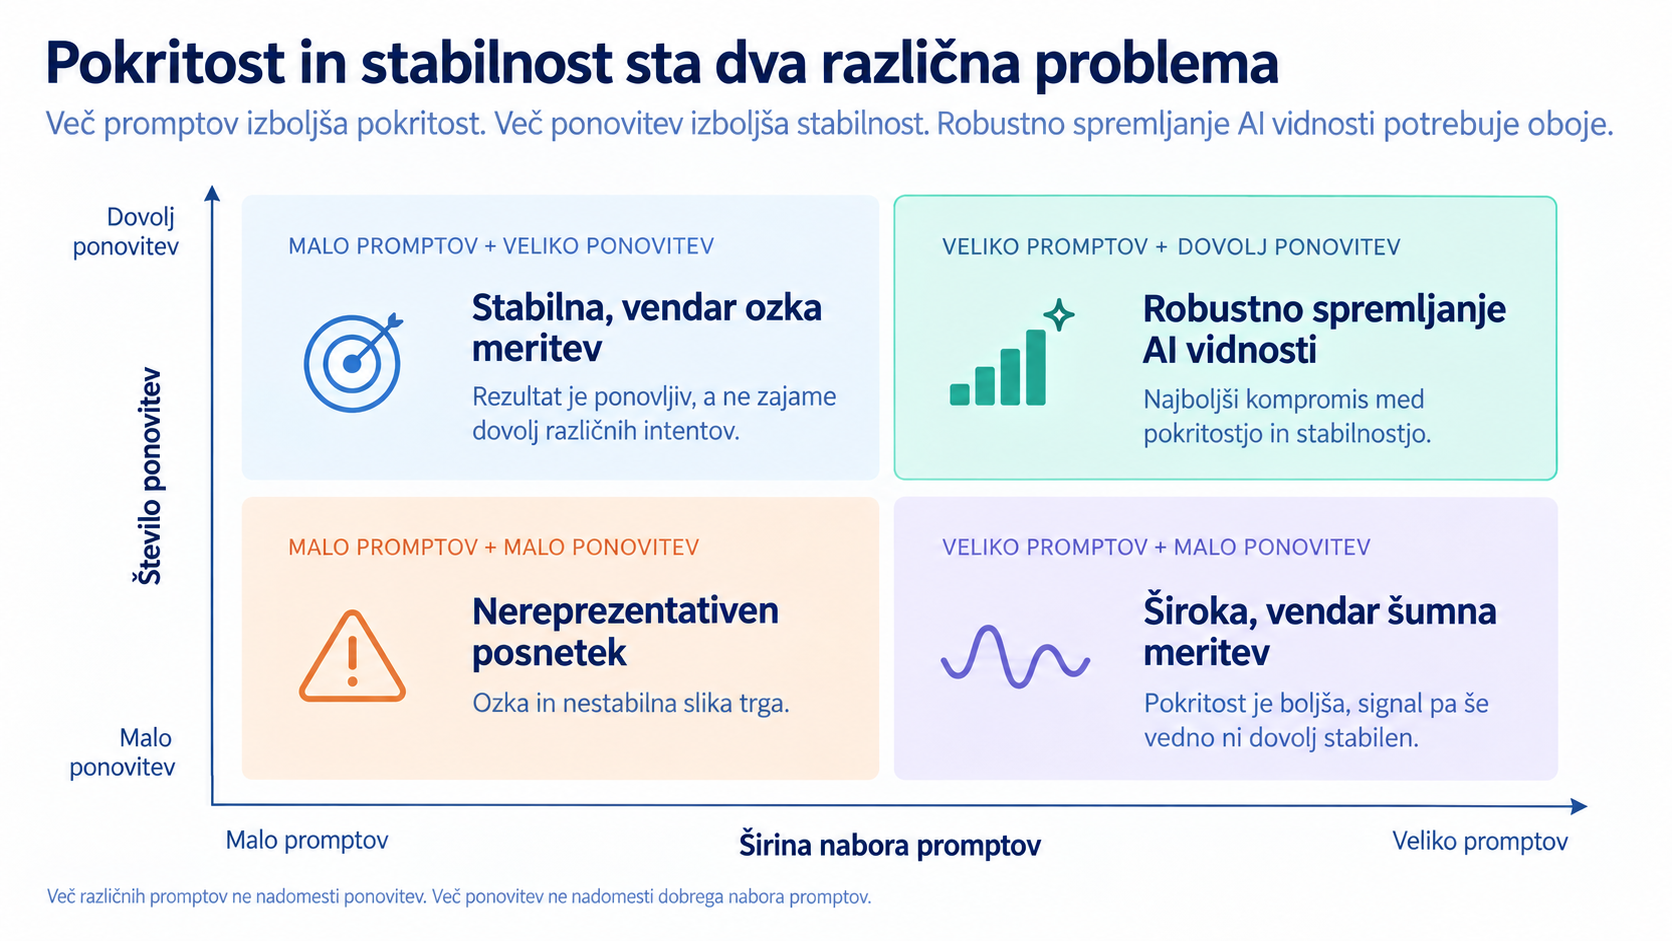
Pomembna terminološka razlika: v tem članku »več ciklov« pomeni več ponovitev istega nabora promptov. To ni isto kot dodajanje več različnih promptov. Več promptov poveča vsebinsko pokritost, več ponovitev pa poveča statistično stabilnost.
Isti prompt ne pomeni istega odgovora
Pri klasičnem analitičnem sistemu pričakujemo, da isti vhod vrne isti rezultat. Pri generativni umetni inteligenci to praviloma ne velja.
Model lahko pri isti poizvedbi:
- izbere drugačen nabor primerov,
- spremeni vrstni red priporočenih ponudnikov,
- uporabi drugačne vire ali asociacije,
- blagovno znamko enkrat omeni in drugič ne,
- poda vsebinsko podoben odgovor, vendar z drugačnim poudarkom.
To ni nujno napaka modela. Gre za lastnost verjetnostnega generiranja odgovorov.
Posledica za merjenje je pomembna: če prompt izvedemo samo enkrat, ne vemo, ali smo zajeli tipičen odgovor ali naključen odklon.
Enkratna meritev je podobna anketi z enim respondentom. Odgovor je resničen, vendar iz njega ne moremo zanesljivo sklepati o celotni populaciji.
Kaj je pokazala razširjena analiza?
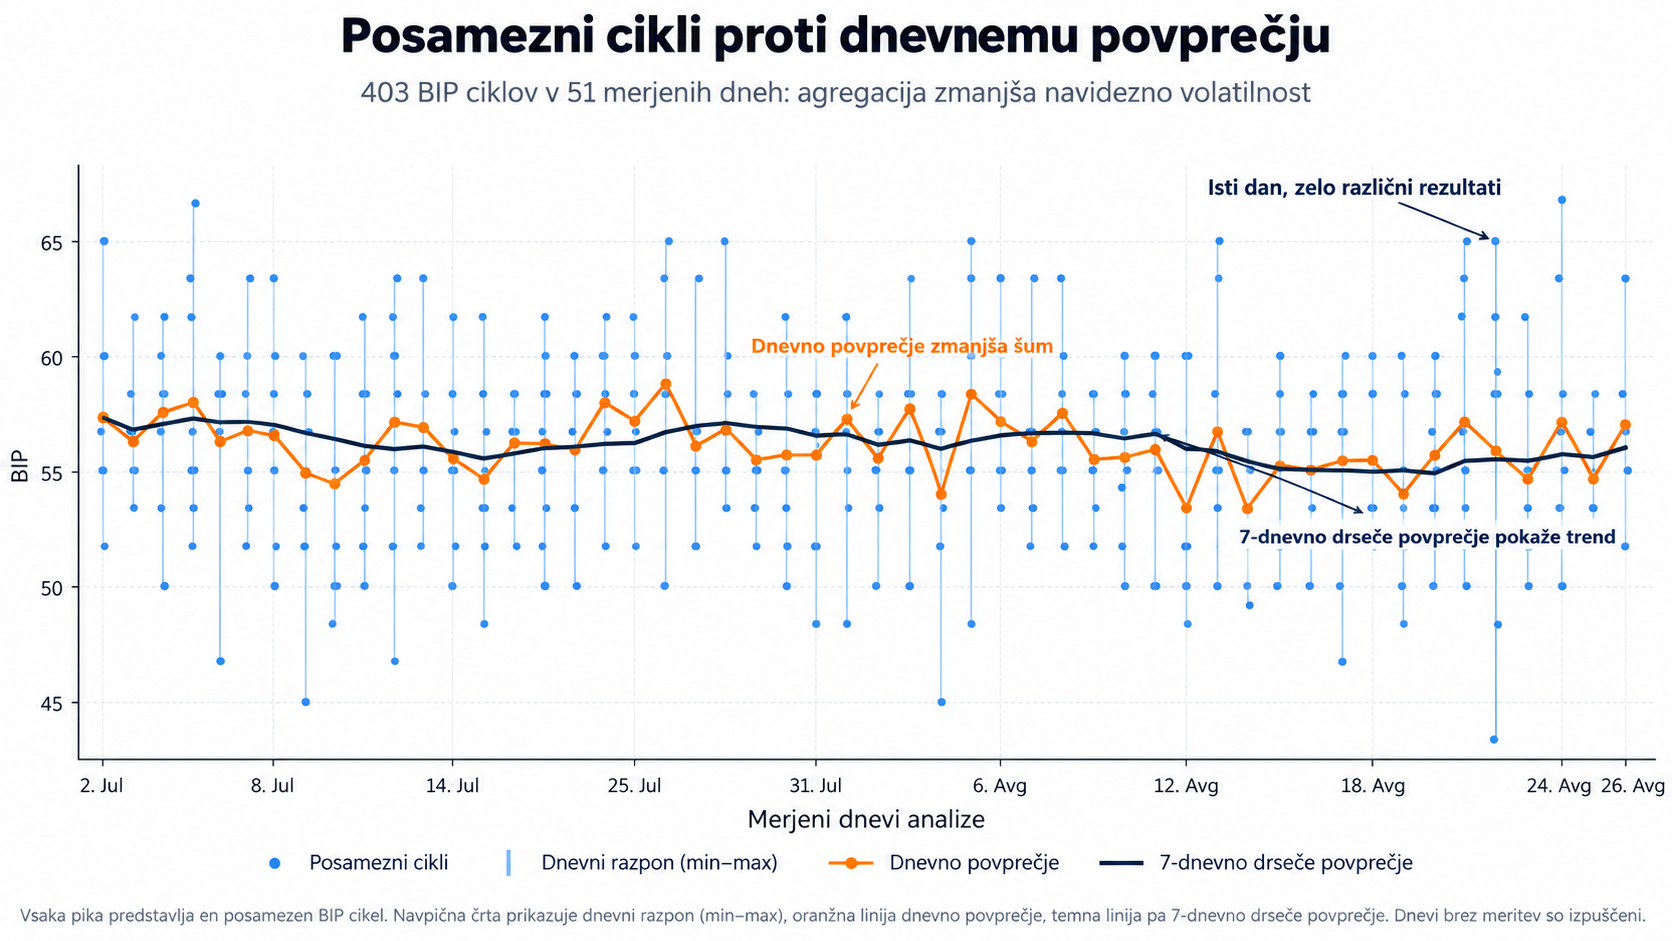
Razširjena analiza je pokazala jasno razliko med dolgoročnim signalom in dnevnim šumom. Povprečni standardni odklon znotraj posameznega dne je znašal 4,02 odstotne točke. Povprečni razpon med najnižjim in najvišjim ciklom istega dne je bil 11,90 odstotne točke, največji zaznani dnevni razpon pa kar 21,67 odstotne točke.
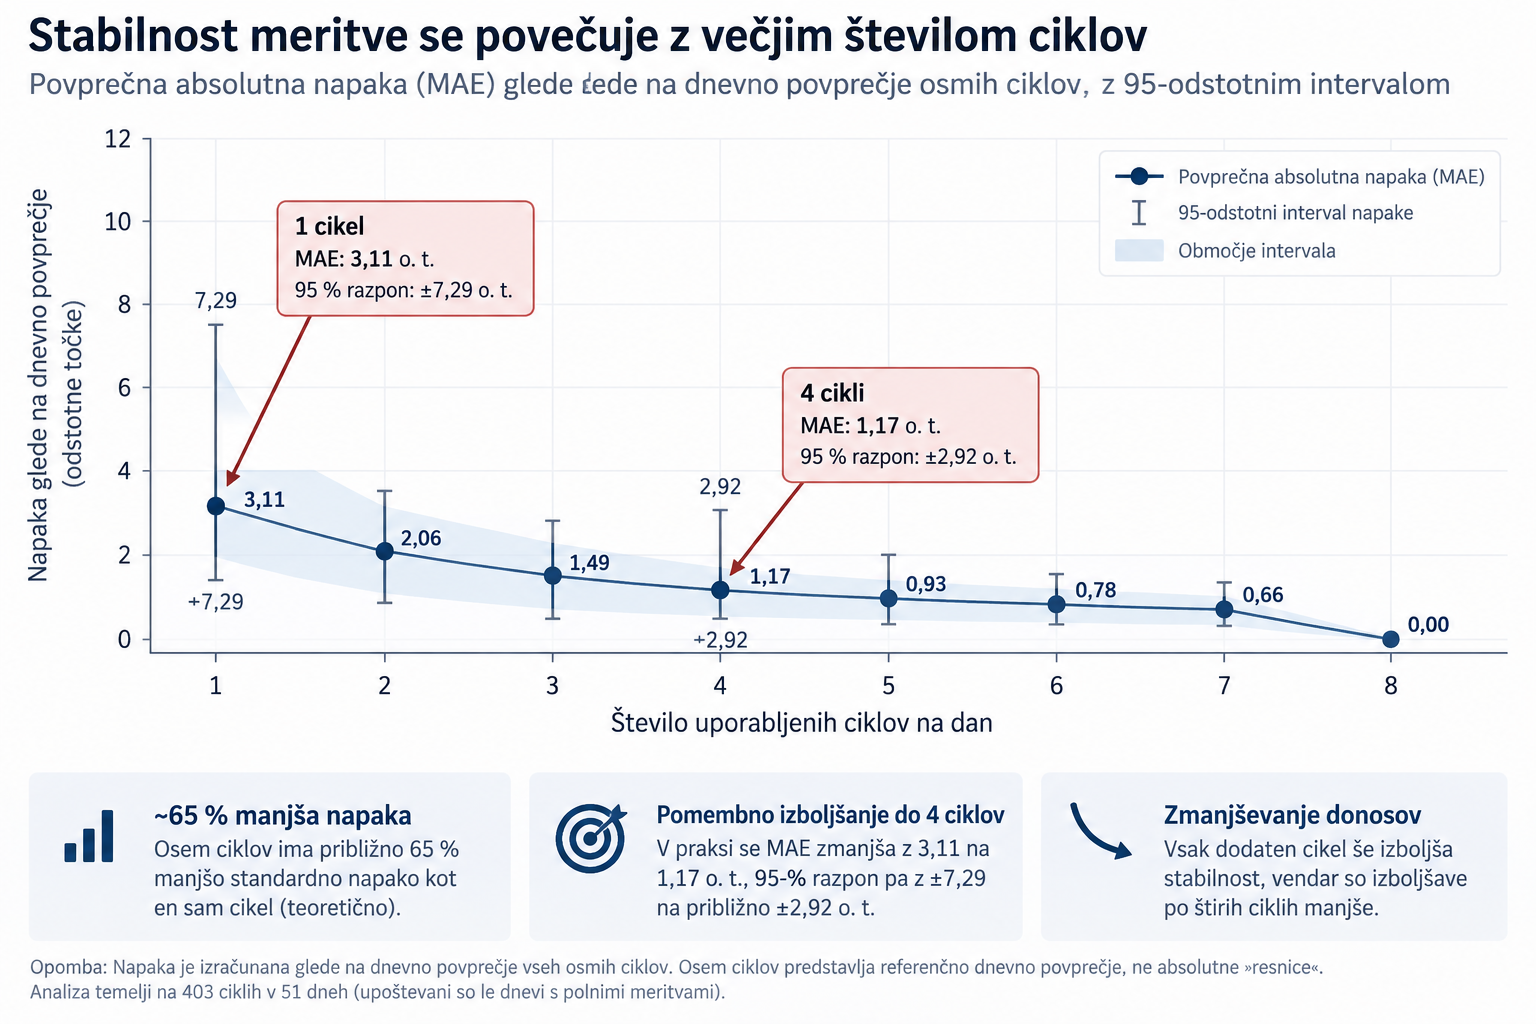
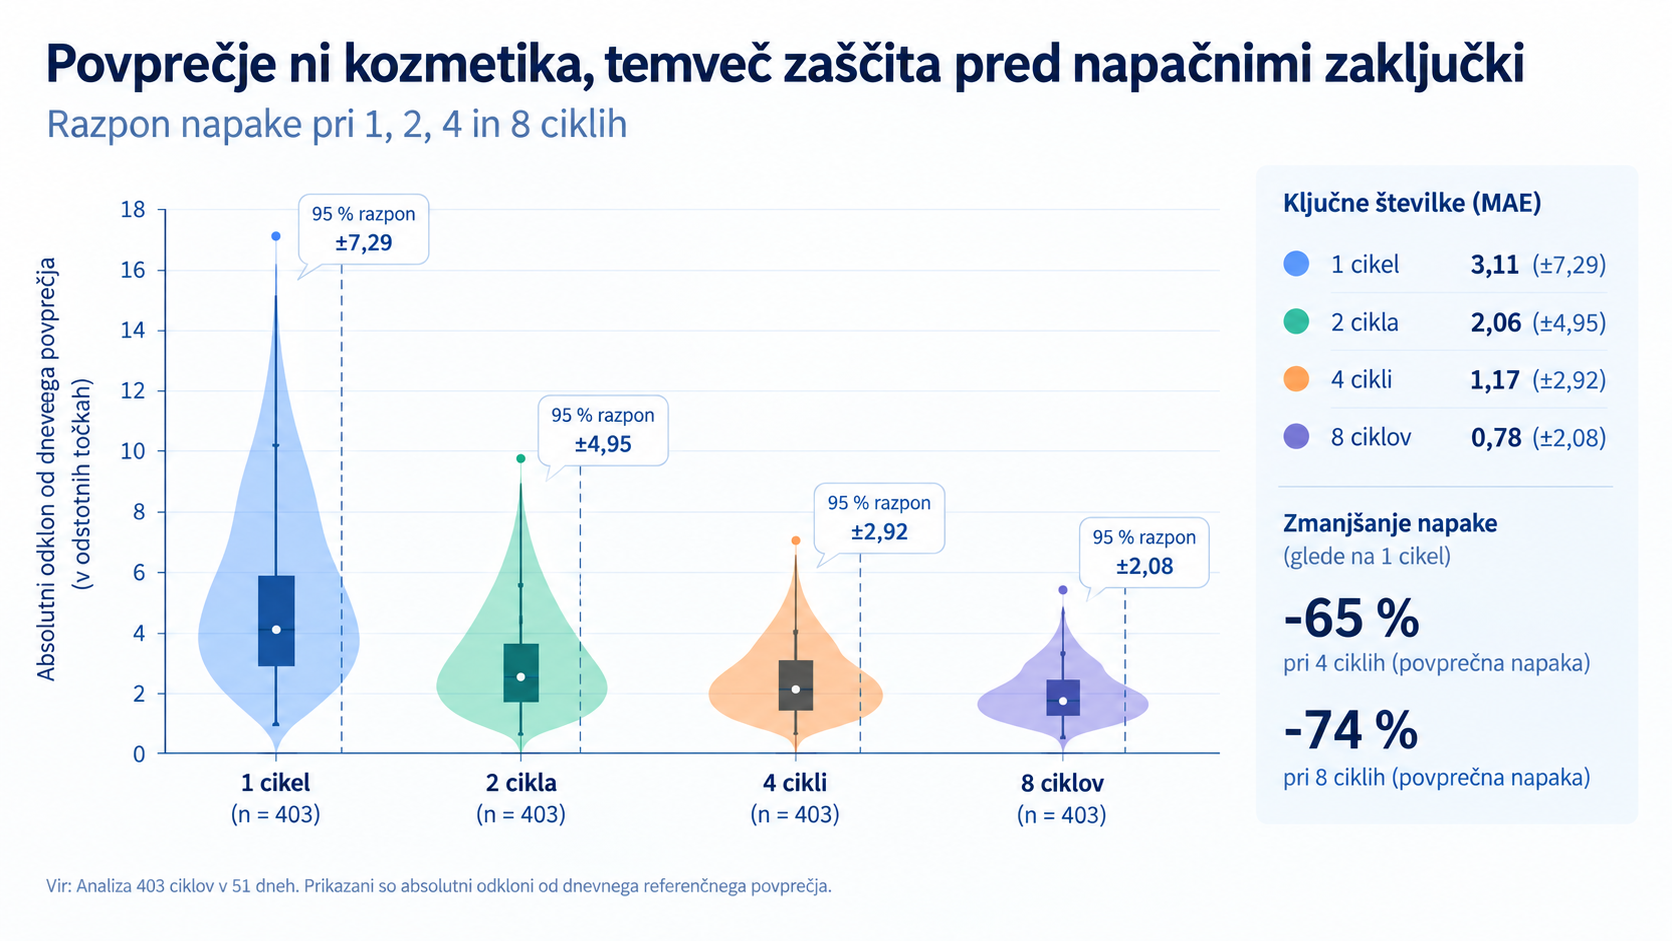
Pri eni sami naključno izbrani izvedbi na dan je povprečna absolutna napaka glede na referenčno dnevno vrednost znašala 3,11 odstotne točke, RMSE pa 3,86 odstotne točke. Približno 95 % enkratnih dnevnih ocen je bilo znotraj ±7,29 odstotne točke od referenčnega dnevnega povprečja. To pomeni, da lahko ena sama izvedba na posamezen dan pokaže precej drugačno sliko, kot jo dobimo iz več opazovanj.
Ko smo cikle združevali, so se zgodile tri stvari:
- Ekstremni dnevni skoki so se zmanjšali.
- Dnevne vrednosti so se približale stabilnemu osrednjemu signalu.
- Trend skozi čas je postal bolj gladek in primernejši za poslovno interpretacijo.
Ključni problem ene izvedbe zato ni nujno dolgoročna pristranskost, temveč dnevna variabilnost. Ko eno izvedbo na dan agregiramo čez daljše obdobje, se naključne napake deloma izničijo: povprečna napaka dolgoročnega povprečja je v naši analizi znašala le 0,45 odstotne točke, 95-odstotni razpon pa približno ±1,11 odstotne točke. Toda ista ena izvedba je precej šibkejša osnova za dnevne spremembe, alarme in kratkoročne odločitve.
Za marketing managerja je to bistveno. Pri eni sami dnevni izvedbi se je smer dnevnega premika z referenčno serijo ujemala le v približno 55 % primerov, korelacija z referenčnimi dnevnimi vrednostmi pa je bila okoli 0,31. Z drugimi besedami: ena izvedba je lahko dovolj za dolgoročno povprečje, vendar je precej nezanesljiva za vprašanje, ali je vidnost danes dejansko zrasla ali padla.
Zakaj več ponovitev statistično izboljša rezultat?
Osnovno statistično pravilo pravi, da se standardna napaka povprečja zmanjšuje približno sorazmerno z 1/√n, kjer je n število neodvisnih ponovitev.
To pomeni, da izboljšanje ni linearno. Osem ciklov ni osemkrat natančnejših od enega. Je pa standardna napaka pri osmih približno 2,83-krat manjša kot pri eni sami izvedbi.
Teoretično razmerje je naslednje:
| Število ciklov | Relativna standardna napaka | Zmanjšanje glede na 1 cikel |
| 1 | 100,0 % | 0,0 % |
| 2 | 70,7 % | 29,3 % |
| 4 | 50,0 % | 50,0 % |
| 8 | 35,4 % | 64,6 % |
Drugače povedano: če so izvedbe približno neodvisne, osem ponovitev zmanjša naključni del napake za približno 65 odstotkov v primerjavi z eno izvedbo.
V praksi cikli niso vedno popolnoma neodvisni. Uporabljajo isti model, isti prompt in podoben kontekst, zato je dejanski učinek lahko nekoliko manjši od teoretičnega. Empirični podatki pa jasno potrjujejo smer: pri štirih ciklih na dan je povprečna absolutna napaka padla z 3,11 na 1,17 odstotne točke, 95-odstotni razpon napake pa z ±7,29 na približno ±2,92 odstotne točke. Več ponovitev torej občutno zmanjša vpliv posameznega odstopanja.
Povprečje ni kozmetika, temveč zaščita pred napačnimi zaključki
Če dnevni BIP temelji na eni sami izvedbi, lahko naključna variacija ustvari več vrst napačnih signalov.
Navidezna rast ali padec
En dan je izbrani cikel nad običajnim razponom, naslednji dan pa pod njim. Na grafu to izgleda kot močan padec, čeprav se dejanska verjetnost vključitve morda ni pomembno spremenila.
Lažni alarmi
Sistem lahko sproži opozorilo o padcu vidnosti, čeprav je sprememba posledica enega netipičnega odgovora. Pogosti lažni alarmi hitro zmanjšajo zaupanje v analitiko.
Napačna primerjava s konkurenti
Če se ciljna znamka v eni izvedbi pojavi, konkurent pa ne, lahko izračun deleža vidnosti začasno močno odstopa. Pri naslednji izvedbi je lahko rezultat obrnjen. To je še posebej problematično pri metrikah, kot so BIP, SOAI in povprečna pozicija omembe.
Prehitra optimizacija
Ekipa lahko spremeni vsebine, prompte ali komunikacijsko strategijo na podlagi šuma. Posledica je optimizacija za naključni odgovor namesto za dejanski tržni signal.
Več različnih promptov in več ponovitev rešujeta dva različna problema
Pri spremljanju AI vidnosti pogosto mešamo dve ločeni dimenziji kakovosti meritve.
Prva je pokritost. Ali nabor promptov dovolj dobro predstavlja različne uporabniške potrebe, faze nakupnega procesa, trge, jezike in kategorije?
Druga je stabilnost. Ali je bil vsak merjeni signal dovoljkrat ponovljen, da posamezen naključni odgovor nima prevelike teže?
Več različnih promptov izboljša pokritost trga. Več ciklov istega nabora izboljša ponovljivost rezultata.
Robusten sistem potrebuje oboje.
Osem ponovitev ne more rešiti slabo izbranega nabora promptov. Po drugi strani pa tudi velik nabor promptov ne odpravi nujno nestabilnosti na ravni posameznega prompta, segmenta ali modela, če je vsaka poizvedba izvedena samo enkrat.
Kvadranti:
- malo promptov + malo ponovitev: nereprezentativen posnetek,
- veliko promptov + malo ponovitev: široka, vendar šumna meritev,
- malo promptov + veliko ponovitev: stabilna, vendar ozka meritev,
- veliko promptov + dovolj ponovitev: robustno spremljanje AI vidnosti.
Koliko ciklov je dovolj?
Univerzalnega števila ni. Potrebno število ponovitev je odvisno od volatilnosti modela, vrste promptov, velikosti nabora, uporabljene metrike in poslovne občutljivosti na napake.
Razširjena analiza omogoča precej jasnejšo praktično razmejitev:
1 cikel na dan je lahko dovolj za posnetek trenutnega odgovora ali za dolgoročno povprečje, če agregiramo veliko dni. Ni pa dovolj zanesljiv kot samostojen temelj za dnevni KPI, zaznavanje dnevnih sprememb ali alarmiranje.
2 do 3 cikli že zmanjšajo pomemben del naključnega šuma in so bistveno boljši od ene same izvedbe, vendar ostaja dnevna negotovost še opazna.
4 cikli so se pokazali kot zelo dober praktičen kompromis za dnevni dashboard: povprečna absolutna napaka je padla na 1,17 odstotne točke, 95-odstotni razpon pa na približno ±2,92 odstotne točke. Zato so štirje cikli smiselna privzeta nastavitev za redno spremljanje. Takšen princip uporabljamo tudi v Imhotep Lens: cilj ni ustvariti čim več meritev, temveč dovolj meritev, da je dnevni signal uporaben in stroškovno smiseln.
8 ciklov je smiselnih tam, kjer želimo maksimalno robustnost: pri občutljivem alarmiranju, statistično strožjem monitoringu, primerjavi obdobij in poročanju, kjer želimo čim manj verjetnosti, da odločitev temelji na naključnem odklonu.
Osem ciklov ni čarobno število in tudi ni nujno potrebno za vsak primer uporabe. Nova analiza kaže izrazit učinek zmanjševanja donosov: največ praktične vrednosti dobimo pri prehodu z ene izvedbe na nekaj ponovitev. Za večino dnevnega spremljanja so štirje cikli zelo dober kompromis med stroškom in stabilnostjo, osem pa ostaja robustnejša izbira za zahtevnejše scenarije.
Kdaj je ena izvedba vseeno dovolj?
Ena izvedba je lahko povsem smiselna, kadar želimo odgovoriti na vprašanje:
»Kaj je model odgovoril v tem konkretnem trenutku?«
Primerna je za:
- pregled posameznega odgovora,
- odkrivanje vsebinskih napak,
- pripravo primera za predstavitev,
- hiter enkratni audit,
- preverjanje, ali prompt tehnično deluje.
Sama po sebi pa ni dovolj zanesljiva za dnevni odgovor na vprašanje:
»Kako verjetno je, da bo AI priporočil našo blagovno znamko?«
Za dnevno merjenje potrebujemo ponovitve, agregacijo in oceno negotovosti. Če nas zanima samo dolgoročno povprečje skozi veliko dni, je lahko že ena dnevna izvedba precej bližje stabilnemu signalu.
Od merjenja odgovorov k merjenju verjetnosti
Največja metodološka napaka pri AI analitiki je, da posamezen odgovor obravnavamo kot stabilno dejstvo.
Pri SEO smo se navadili, da ena pozicija v enem trenutku ni celotna slika. Spremljamo več ključnih besed, naprave, lokacije, obdobja in trende. Pri AI vidnosti mora biti standard vsaj enako strog.
Dober sistem ne meri samo, ali je bila znamka enkrat omenjena. Meri:
- kako pogosto je vključena,
- na katerih promptih in intentih,
- v katerih modelih, jezikih in trgih,
- kako stabilen je rezultat,
- kako velik je odklon,
- ali je sprememba večja od običajnega šuma.
To je tudi razlog, zakaj je Imhotep Lens zasnovan okoli ponavljajočih meritev: hrani posamezne rezultate, dnevni BIP pa izračunava iz agregiranih opazovanj. Namen ni ustvariti več podatkov zaradi podatkov samih, temveč ločiti signal od naključne variacije ter uporabniku pokazati, katerim spremembam lahko dejansko zaupa.
Zaključek
Ena izvedba prompta lahko pove, kaj je AI model odgovoril enkrat. Čez daljše obdobje lahko njeno povprečje celo precej dobro oceni splošno raven vidnosti, vendar posamezen dnevni rezultat ni dovolj stabilen za zanesljivo interpretacijo kratkoročnih sprememb.
Analiza 403 ciklov v 51 dneh je potrdila temeljno statistično logiko: z več ponovitvami se zmanjša vpliv naključnih odklonov, dnevna ocena postane stabilnejša, trendi pa bolj uporabni za poslovno odločanje. Pri prehodu z ene na štiri ponovitve je povprečna dnevna absolutna napaka padla z 3,11 na 1,17 odstotne točke.
Najpomembnejše vprašanje zato ni samo, kateri model in katere prompte spremljamo. Vprašati se moramo tudi:
Koliko neodvisnih opazovanj je v resnici za številko, ki jo prikazujemo kot KPI?
Brez tega AI visibility monitoring hitro postane zbirka zanimivih posnetkov zaslona. Z dovolj ponovitvami, dobro metodologijo in jasno oceno stabilnosti pa lahko postane resen marketinški merilni sistem.
Metodološka opomba
Analiza temelji na 403 BIP ciklih iz 51 merjenih dni enega realnega projekta. V 47 dneh je bilo izvedenih vseh osem ciklov; ti dnevi so bili uporabljeni za analizo napake glede na število ponovitev. Referenčni dnevni BIP je bil izračunan kot povprečje vseh osmih ciklov. Ta referenca ni absolutna »prava« vrednost, temveč najboljši razpoložljivi empirični približek znotraj analiziranega nabora. Rezultati enega projekta ne določajo univerzalne volatilnosti za vse modele, kategorije in jezike, zelo jasno pa potrjujejo splošno načelo: agregiranje več ponovitev zmanjšuje naključni šum in povečuje stabilnost dnevne ocene.